머신러닝의 학습·검증·추론 구조를 설명하고 분류·회귀·이상 탐지 문제에 적용하기 전 데이터와 운영 조건을 판단하는 기준을 정리합니다.
주제와 적용 범위
머신러닝은 명시적인 규칙만으로 해결하기 어려운 패턴을 데이터에서 학습해 새로운 입력에 대한 분류·수치 예측 등을 수행하는 방법입니다. 학습 데이터에서 높은 점수를 얻는 것보다 운영 환경의 새로운 데이터에 일반화되는지가 중요합니다.
모든 문제에 머신러닝이 필요한 것은 아닙니다. 안정적인 규칙과 임계값으로 설명할 수 있는 문제는 전통 알고리즘이 더 검증하기 쉽고 유지비용도 낮을 수 있습니다.
핵심 구조와 판단 기준
문제 정의
예측 대상, 입력 시점과 결과를 사용할 업무 결정을 먼저 정합니다. 정확도 향상 수치가 실제 오류 비용을 줄이는지 연결해야 합니다.
데이터 분리
학습·검증·테스트 데이터를 시간과 개체 기준으로 분리해 정보 누수를 막습니다. 클래스 불균형과 누락·오표기 데이터를 확인합니다.
운영 추론
전처리와 모델을 같은 버전으로 배포하고 입력 분포, 지연 시간과 오류율을 관측합니다. 데이터가 변하면 재평가와 재학습 기준이 필요합니다.
적용 가능한 업무
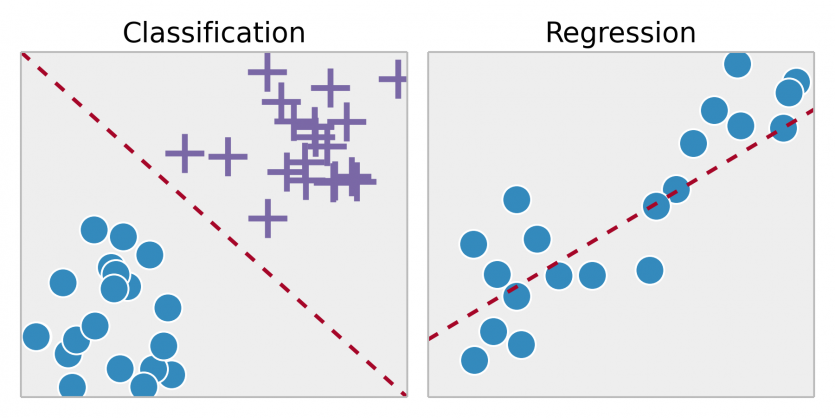
- 정상·불량 이진 분류
- 수요·값 예측 회귀
- 설비 데이터 이상 탐지
- 텍스트·이미지 분류
데이터와 운영 품질 기준
학습 도구의 자동 결과나 단일 평가 점수를 운영 성능으로 단정하지 않습니다. 데이터 출처, 분할 방식, 오류 비용과 실행 환경을 기록하고 새로운 데이터에서 재현되는지 확인합니다.
- 예측이 바꿀 업무 결정
- 수집 가능한 대표 데이터량
- 오검·미검 또는 과대·과소 예측 비용
- 설명 가능성과 응답 시간
- 모델 버전·감시·재학습 담당
착수 전 확인 사항
업무 결정과 연결된 목표 지표, 사용할 수 있는 데이터와 개인정보·저작권 범위를 먼저 확인합니다. 모델과 전처리, 실행 환경을 같은 버전 단위로 관리하고 교체·중단 가능한 절차를 마련합니다.
공식 자료와 개발 문의
차오름소프트의 공개 구축사례에서 관련 기술 적용 범위를 확인할 수 있습니다. 견적 문의 시 데이터 구조와 필요한 결과를 전달하면 검증·개발 범위를 구체적으로 검토할 수 있습니다.