ML.NET으로 텍스트 감정 이진 분류 모델을 만들 때 데이터 레이블, 전처리, 평가 지표와 실제 서비스 적용 전 확인할 한계를 정리합니다.
주제와 적용 범위
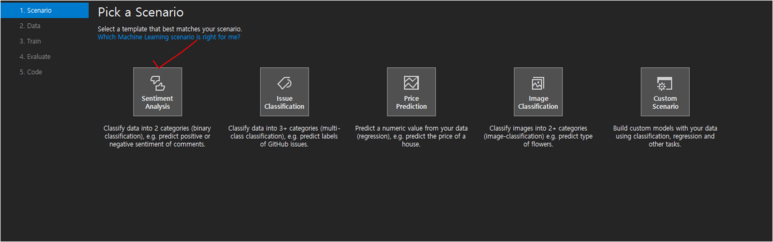
감정 분석은 텍스트를 긍정·부정 같은 레이블로 분류하는 작업입니다. ML.NET 예제는 이진 분류 파이프라인을 이해하는 데 유용하지만 짧은 댓글의 문맥, 반어, 중립과 도메인별 표현을 완전히 해결하지는 않습니다.
학습 데이터와 운영 데이터의 언어·주제가 다르면 평가 점수가 유지되지 않을 수 있습니다. 실제 업무 문장과 오류 비용을 기준으로 별도 검증해야 합니다.
핵심 구조와 판단 기준
데이터와 레이블
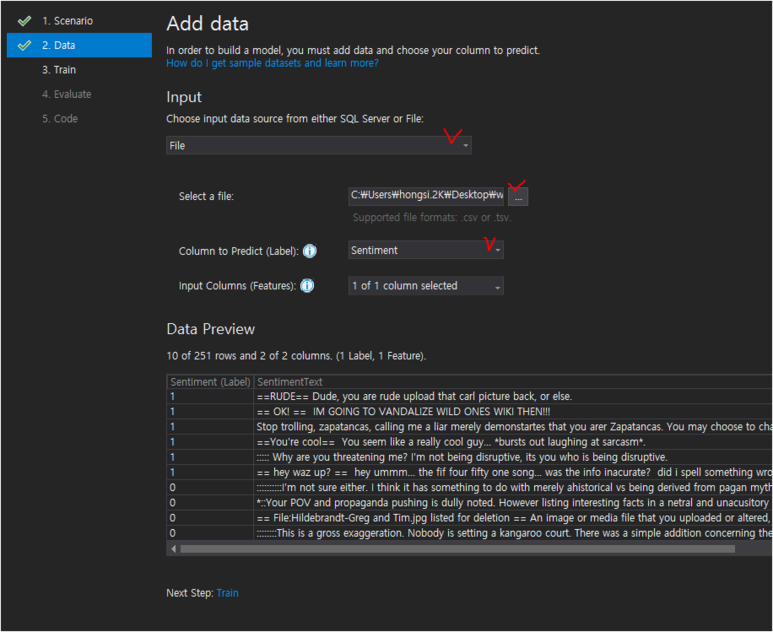
중복, 개인정보, 자동 생성 문장과 라벨 불일치를 제거합니다. 긍정·부정 정의와 중립·판단 불가 처리 기준을 문서화합니다.
특징과 학습
전통적인 텍스트 특징 또는 현재 지원되는 텍스트 분류 방식을 선택합니다. 학습·테스트 분할 전 동일 원문의 변형이 양쪽에 섞이지 않게 합니다.
평가와 운영
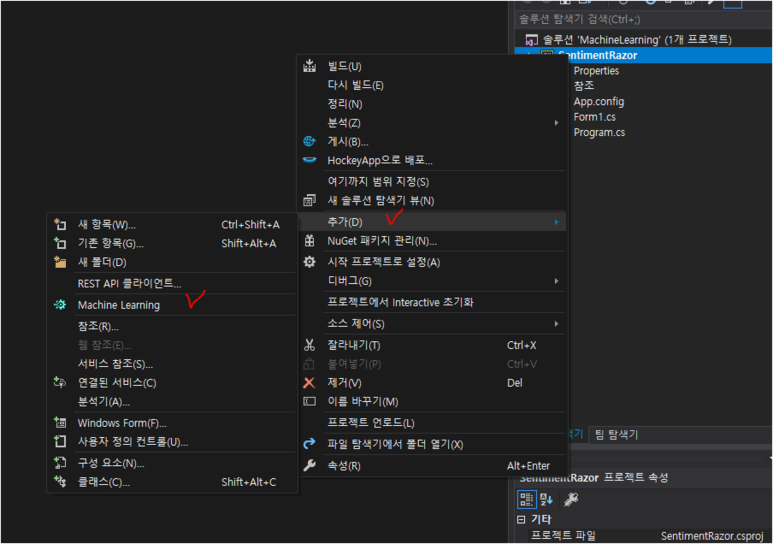
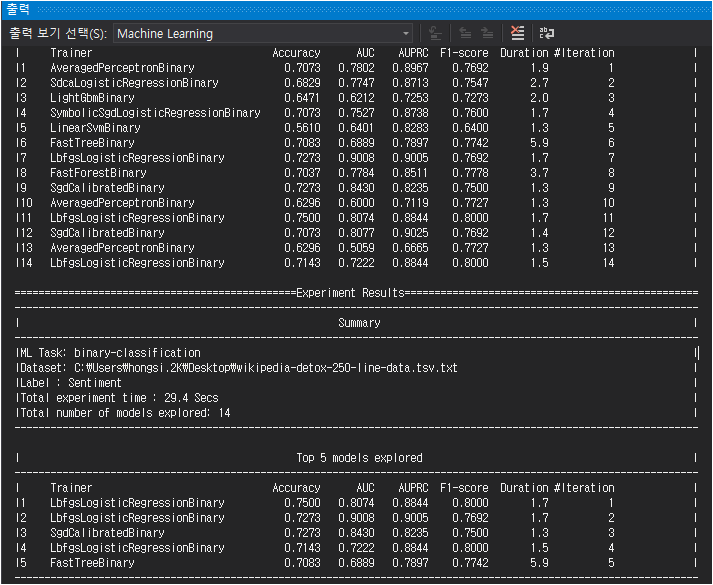
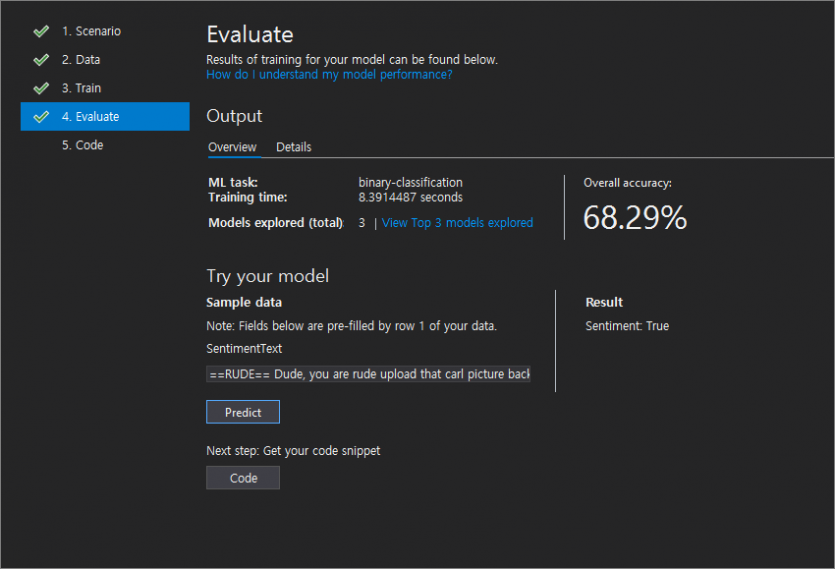
정확도만 보지 않고 정밀도·재현율과 혼동 행렬을 확인합니다. 낮은 확신 결과는 수동 검토로 보내고 모델·전처리 버전을 함께 기록합니다.
적용 가능한 업무
- 댓글·문의의 긍정·부정 기준 실험
- 고객 의견의 우선 검토 보조
- 텍스트 분류 파이프라인 학습
- C# 서비스의 로컬 모델 추론
데이터와 운영 품질 기준
학습 도구의 자동 결과나 단일 평가 점수를 운영 성능으로 단정하지 않습니다. 데이터 출처, 분할 방식, 오류 비용과 실행 환경을 기록하고 새로운 데이터에서 재현되는지 확인합니다.
- 대상 언어·업무와 레이블 정의
- 클래스 균형·중복·개인정보
- 오분류의 실제 업무 영향
- 판단 보류 임계값과 수동 검토
- 데이터 변화·재평가·모델 교체
착수 전 확인 사항
업무 결정과 연결된 목표 지표, 사용할 수 있는 데이터와 개인정보·저작권 범위를 먼저 확인합니다. 모델과 전처리, 실행 환경을 같은 버전 단위로 관리하고 교체·중단 가능한 절차를 마련합니다.
공식 자료와 개발 문의
차오름소프트의 공개 구축사례에서 관련 기술 적용 범위를 확인할 수 있습니다. 견적 문의 시 데이터 구조와 필요한 결과를 전달하면 검증·개발 범위를 구체적으로 검토할 수 있습니다.